Umělá inteligence a strojové učení (SŠ)
| Typický ročník | 4. SŠ |
| Interval vhodných ročníků | 2. SŠ – 4. SŠ |
| Učivo | umělá inteligence, strojové učení, metody AI, prohledávání, splňování podmínek, optimalizace, zkreslení v datech, trénovací data, hodnocení modelu, limity a rizika AI |
| Předcházející modul | Základy umělé inteligence a strojového učení |
| Bezprostřední výsledky učení |
|
| Související RVP výsledky učení |
|
Tento modul nabízí úvod do klíčových principů umělé inteligence a strojového učení s důrazem na porozumění základním pojmům, typickým úlohám a způsobu, jakým se modely učí ze vstupních dat. Nezabývá se do hloubky konkrétními technologiemi, které se rychle vyvíjejí, ale soustředí se na stabilní a nadčasové myšlenky – od prohledávání a optimalizace až po principy generalizace a zkreslení v trénovacích datech. Téma je zasazeno do kontextu reálného světa, s důrazem na kritické myšlení, reflexi možností a omezení AI a její dopad na společnost.

Tento blok doporučujeme řešit.

Vymezení umělé inteligence
Souhrn tématu
Umělá inteligence (zkráceně AI z anglického Artificial Intelligence) označuje programy řešící složité problémy (např. hraní šachů nebo řízení auta) a také obor informatiky zabývající se vytvářením těchto programů. Umělá inteligence nejsou jen roboti, častěji jde o počítačový program bez fyzické podoby. Umělá inteligence má využití všude, kde existují složité problémy, například ve zpracování přirozeného jazyka, robotice a počítačovém vidění.
Definice umělé inteligence
Neexistuje jednotná definice umělé inteligence. Někdy se za umělou inteligenci považují programy, které se chovají jako lidé, to je ale omezující v tom, že lidé se často nechovají inteligentně, dělají chyby a některé složité problémy řešit neumí. Vhodnější je proto považovat za umělou inteligenci programy, které se chovají inteligentně (racionálně). Inteligentní chování znamená, že se program snaží maximalizovat očekávaný užitek (např. pravděpodobnost výhry v šachu).
Turingův testV polovině 20. století navrhl Alan Turing známý test na rozpoznání umělé inteligence: Pokud nejsme při písemné komunikaci schopni rozlišit, zda si povídáme s člověkem nebo programem, pak můžeme daný program považovat za umělou inteligenci. Turingův test odpovídá definici umělé inteligence jako programu, který se chová jako člověk, což je omezující – aby program prošel tímto testem, nesmí odpovídat příliš rychle a musí záměrně dělat chyby, jaké by udělal člověk (např. při násobení velkých čísel).
AI efekt
Umělá inteligence řeší složité problémy – problémy, jejichž řešení ještě donedávna vyžadovalo lidskou inteligenci. Jakmile si zvykneme na to, že daný problém umí počítače řešit, přestaneme ho považovat za složitý a program, který ho řeší, přestaneme považovat za umělou inteligenci. Tento neustálý posun toho, co považujeme za umělou inteligenci, se označuje jako AI efekt.
Úzká vs. obecná umělá inteligence
Umělá inteligence: pojmy
Souhrn tématu
Pro správné pochopení zpráv a jiných textů o umělé inteligenci je potřeba znát řadu pojmů. Jejich přesný význam je často komplikovaný a ne úplně jednoznačný (mají třeba více významových odstínů a použití). Naše stručné popisy se snaží zachytit jejich základní podstatu.
Typy a kategorie
Metody, techniky, přístupy
Oblasti, aplikace, úlohy
Historie umělé inteligence
Souhrn tématu
Před rokem 1950
- Karel Čapek napsal divadelní hru R.U.R, ve které bylo poprvé použito slovo robot (1920).
- První počítače, používané především pro výpočty v průběhu druhé světové války (např. pro dešifrování).
- První model neuronu, který se stal základem neuronových sítí.
1950–1960
- Základy umělé inteligence jako vědy, první principy algoritmů umělé inteligence.
- Alan Turing navrhuje test strojové inteligence (Turingův test), kdy člověk musí rozpoznat, zda komunikuje s počítačem či člověkem.
- Začátek vývoje průmyslových robotů.
1960–1970
- Využívání pravidlových systémů a logického odvozování, rozvoj technik prohledávání stavového prostoru.
- První chatovací programy (např. Eliza).
- První programy hrající deskové hry (např. dámu, piškvorky) na úrovni amatéra.
- První samostatně se pohybující roboti (např. Shakey).
- Základy zpracování přirozeného jazyka, první demonstrace strojového překladu.
- Základy rozpoznávání obrazu.
1970–1990
Využití a schopnosti umělé inteligence
Souhrn tématu
Mezi typické aplikace umělé inteligence patří:
- robotika (např. robotický vysavač, průmysloví roboti, samořídící auta),
- doporučovací systémy (např. doporučování filmů, hudby, knih),
- zpracování přirozeného jazyka (např. překládání mezi jazyky, internetový vyhledávač, detekce spamu),
- rozvrhování a plánování (např. navigace, tvorba školního rozvrhu, plánování výroby v továrně),
- počítačové vidění (např. rozpoznání osob, SPZ či rostliny na fotce),
- počítačové hry (např. šachový program, chování nehráčských postav).
Umělá inteligence má využití především v oblastech, kde se vyskytují opakované, repetitivní činnosti (např. obsluha výrobních pásů, řízení strojů, základní administrativní úkony) nebo kde je potřeba zpracovat velké množství dat a hledat v něm vzory (např. odpovídání na otázky na základě textů na webu, personalizované doporučování produktů, detekce podvodných bankovních transakcí).
Umělá inteligence zatím nemá schopnosti, které vyžadují složitější manuální operace (např. stříhání vlasů), koordinaci rozmanitých činností (např. rekonstrukce bytu), sociální dovednosti a empatii (např. zdravotnictví) či kreativitu a samostatné formulování cílů (např. výzkum).
Umělá inteligence: realita a fikce
Souhrn tématu
Umělá inteligence se často vyskytuje i v uměleckých dílech (knihy, filmy, divadelní hry). Její zobrazení ve fikci však často neodpovídá skutečnosti a je tedy užitečné umět rozlišovat, co je realita a co fikce. Fikce neumožňuje získat lepší představu o aktuální podobě a schopnostech umělé inteligence, ale přináší zajímavé etické a filozofické otázky.
Příklady známých fiktivních robotů a programů:
Golem, Frankenstein: Umělé myslící stroje z pověstí či knih, předchází použití slova robot.
Roboti v divadelní hře R.U.R. od Karla Čapka (první použití slova robot).
HAL 9000: Program řídící vesmírnou loď z filmu 2001: Vesmírná odysea. Známý tím, že se snaží zabít kosmonauty, aby dosáhl splnění zadaného úkolu.
Umělá inteligence ve filmu Matrix, která zotročila lidstvo jako zdroj energie.
Marvin: Paranoidní robot z knižní série Stopařův průvodce po galaxii.

Vymezení umělé inteligence
Rozhodovačka • těžké


Vymezení umělé inteligence (těžké) • NGN
Typicky zabere: 8 min
Vymezení umělé inteligence
Doplňování textu • střední

Vymezení umělé inteligence (střední) • NJ6
Typicky zabere: 4 min
Umělá inteligence: pojmy
Rozhodovačka • těžké

Umělá inteligence: pojmy (těžké) • M4V
Typicky zabere: 6 min
Historie umělé inteligence
Doplňování textu • střední

Historie umělé inteligence (střední) • NJD
Typicky zabere: 4 min
Využití a schopnosti umělé inteligence
Pexeso • střední

Využití a schopnosti umělé inteligence (střední) • NZJ
Typicky zabere: 4 min
Umělá inteligence: realita a fikce
Rozhodovačka • těžké

Umělá inteligence: realita a fikce (těžké) • M4X
Typicky zabere: 5 min
Zpracování přirozeného jazyka
Souhrn tématu
Zpracování přirozeného jazyka (angl. natural language processing) je obor na pomezí informatiky (specificky umělé inteligence) a lingvistiky, který zkoumá analýzu a generování psaného či mluveného slova. Mezi úlohy zpracování přirozeného jazyka patří:
- klasifikace textu (detekce spamu, určení žánru, určení autorství)
- shlukování textů (vytvoření skupin podobných zpráv nebo souvisejících soudních případů)
- korektura textu (kontrola pravopisu – spell-check, kontrola gramatiky – grammar check)
- generování textu (odpovídání na otázky, shrnování textu, strojový překlad)
- rozpoznávání řeči (řeč → text) a syntéza řeči (text → řeč)
- popisování obrázků (obrázek → text) a generování obrázků (text → obrázek)
Pravidlový přístup
Dříve se na tyto úlohy využívaly pravidlové přístupy snažící se zachytit pravidla daného jazyka (např. časování sloves). Analýza textu byla rozdělena do několika navazujících úrovní (jazykových rovin): 1. morfologie (konstrukce slov), 2. syntaxe (skládání vět), 3. sémantika (význam vět) a 4. pragmatika (použití vět v kontextu). Postihnout přirozený jazyk pomocí pravidel se však ukázalo jako obtížné.
Komplikace zpracování přirozeného jazykaKaždé pravidlo má řadu výjimek a texty v přirozeném jazyce obsahují překlepy a jiné chyby, které je také potřeba modelovat, chceme-li textu porozumět. Další komplikací je nejednoznačnost na mnoha úrovních: homonyma, tj. slova s více možnými významy (los, stát, koruna), věty s více možnými významy („Sněz rychle chladnoucí polévku.“), zájmena odkazující se na dříve uvedené objekty (anafory) a další odkazy do jiných částí textu nebo i mimo něj (já, teď). Význam vět nelze vždy určit z významu dílčích slov, například při použití idiomů, metafor a metonymií.
Strojové učení
V dnešní době se zpracování přirozeného jazyka řeší téměř výhradně využitím strojového učení, které dosahuje výrazně lepších výsledků než pravidlové přístupy. K učení se využívají rozsáhlé kolekce textových dokumentů označované jako korpusy. Korpusy obsahují například digitalizované knížky, online encyklopedie (Wikipedia), někdy dokonce texty z většiny dostupných webových stránek a mohou tak mít i miliardy slov.
ChatGPT
Robotika
Souhrn tématu
Robotika se zabývá vývojem robotů, tedy strojů, které se pohybují v prostoru, vnímají své okolí a na základě jeho stavu se rozhodují. Roboti mají uplatnění v průmyslu (robotická ramena), dopravě (autonomní auta) i domácnosti (robotický vysavač).
Je „kuchyňský robot“ robot?Navzdory pojmenování kuchyňský robot technicky robotem spíše není, protože nevnímá své okolí a nedělá žádná autonomní rozhodnutí.
Slovo „robot“ je odvozené ze slova „robota“ (práce poddaných) a bylo poprvé použito v divadelní hře R.U.R. (Rossumovi univerzální roboti) Karla Čapka v roce 1920. Android je označení pro humanoidní roboty, tedy roboty, kteří mají lidskou podobu. Robot však obecně lidskou podobu mít nemusí, pro mnohé aplikace to není ani potřeba, ani žádoucí (např. robotický vysavač). Měl by ale mít nějakou mechanickou část. (Pro čistě virtuální roboty, tedy programy automatizující činnosti, se někdy používá pojem bot.)
Části robota
Senzory umožňují robotovi vnímat prostředí. Několik příkladů:
- GPS = určování polohy pomocí družic obíhajících Zemi
- radar = měření vzdáleností od okolních objektů pomocí radiových vln
- lidar = měření vzdáleností od okolních objektů pomocí světelných paprsků (měří čas, za jak dlouho se vrátí)
- sonar = měření vzdálenosti pomocí zvukových (typicky ultrazvukových) vln
- kamera = zachycení obrazu, užitečné pro kategorizaci objektů
- jednotka inerciálního měření (angl. Inertial Measurement Unit, IMU) kombinuje gyroskop, akcelerometr (a někdy také magnetometer) k určení orientace, rychlosti a zrychlení stroje
Řídící jednotka, typicky realizována skrze jednočipový počítač (mikrokontrolér), umožňuje robotovi zpracovat informace ze senzorů a rozhodnout se, jak reagovat.
Počítačové vidění
Souhrn tématu
Počítačové vidění je oblast umělé inteligence zabývající se získáváním informací z obrazových dat. Obrazová data nejsou jen fotky a obrázky, ale také videa, snímky medicínských měření (rentgen, ultrazvuk) a snímky z různých senzorů (radar, sonar). Typické úlohy počítačového vidění jsou:
- rozpoznání obrazu – určení kategorie objektu (druh květiny na fotce, ručně napsaný znak)
- detekce objektů – identifikace různých objektů včetně jejich lokalizace na snímku (chodci, tváře, dopravní značky)
- segmentace obrazu – rozdělení obrazu na jednotlivé části nebo objekty (oddělení popředí a pozadí fotky, obarvení různých druhů tkání)
- rozpoznávání naskenovaného textu (OCR z angl. optical character recognition)
- rozpoznávání tváří (identifikace osob na fotkách)
- určení druhu rostliny či zvířete na fotce
- analýza medicínských měření (např. rentgenových snímků)
- kontrola kvality výrobků (automatické odhalení defektů)
- detekce událostí na videu (např. krádež zachycená bezpečnostním kamerovým systémem)
- vyhledávání obrázku podle textového popisu (nebo obrázků podobných zadanému obrázku)
- autonomní auta (např. detekce hranic vozovky, ostatních aut, chodců, rozpoznání dopravních značek)
- roboti vnímající a reagující své okolí (např. chycení předmětu)
Počítačové vidění nelze řešit pomocí ručně zapsaných pravidel. (I tentýž předmět vypadá pokaždé jinak podle toho, jak je daleko, natočený, osvětlený nebo částečně zakrytý.) Proto se využívá strojové učení, kdy se program učí obecné rysy různých objektů na základě velkého množství příkladů. (Pokud se má program naučit klasifikovat různé druhy zvířat, potřebuje k učení fotky všech různých druhů, které má rozlišovat, ideálně v mnoha různých situacích.)
Základní rysy obrázků mohou být například hrany a rohy. Takové rysy lze z původního obrázku získat pomocí konvoluce, což je transformace obrázku, při které je každý pixel nahrazen váženým součtem hodnot pixelů v jeho okolí. Hodnoty vah mohou být různé a označují se jako tzv. konvoluční jádro (angl. kernel). Dříve bylo běžné určit tyto rysy manuálně a použít je jako vstup do jednoduchého modelu.
Dnes se využívají složitější modely, které se automaticky učí vhodné rysy samy extrahovat. (Potřebují však ještě větší množství příkladů než jednodušší modely, které používaly manuálně zadané rysy.) Nejčastěji se využívají hluboké neuronové sítě. Neuronové sítě jsou volně inspirované strukturou mozku, ale jde v podstatě jen o složitou matematickou funkci s mnoha parametry, jejichž hodnoty se učí z dat. Slovo „hluboké“ se zde odkazuje na fakt, že sítě obsahují mnoho vrstev, které postupně zachycují složitější rysy a vzory (hrany → základní geometrické tvary → komplexní tvary → „kočkovitost“ atp.). Na úlohy počítačového vidění se dobře hodí konvoluční neuronové sítě, které obsahují vrstvy provádějící konvoluci. Váhy konvoluce nejsou dané dopředu, učí se z dat.
Zpracování přirozeného jazyka
Doplňování textu • střední
Zpracování přirozeného jazyka (střední) • NKC
Typicky zabere: 5 min
Zpracování přirozeného jazyka
Rozhodovačka • střední
Zpracování přirozeného jazyka (střední) • NEP
Typicky zabere: 5 min
Robotika
Doplňování textu • střední
Robotika (střední) • NKB
Typicky zabere: 5 min
Robotika
Rozhodovačka • střední
Robotika (střední) • NEU
Typicky zabere: 4 min
Robotika
Rozhodovačka • těžké
Robotika (těžké) • NEV
Typicky zabere: 6 min
Počítačové vidění
Rozhodovačka • střední

Počítačové vidění (střední) • NE1
Typicky zabere: 5 min
Aplikace umělé inteligence: mix
Rozhodovačka • střední

Aplikace umělé inteligence: mix (střední) • NGR
Typicky zabere: 4 min
Úlohy a metody umělé inteligence
Souhrn tématu
Na první pohled vypadá každý nový problém jinak, ale při vhodné abstrakci se často ukáže, že jde o jeden ze známých typů úloh, pro jehož řešení můžeme využít standardní postupy a algoritmy.
Typy úloh umělé inteligence
Mezi typy úloh řešených v umělé inteligenci patří:
- plánování – nalezení (nejkratší) posloupnosti akcí, která nás dostane do cíle (nalezení cesty z bludiště, poskládání Rubikovy kostky, naplánování cesty auta do zadané lokace, řešení Sokobana, Autíček a podobných logických úloh)
- splňování podmínek – nalezení hodnot proměnných, které splňují různá provázaná omezení (tvorba školního rozvrhu, řešení sudoku a podobných logických úloh)
- optimalizace – hledání hodnot proměnných minimalizující nebo maximalizující zadanou funkci (sbalení batohu s nejvyšší hodnotou vybraných předmětů, hledání receptu na nejlepší sušenky)
- řízení – nalezení strategie předepisující vhodnou akci pro různé situace (hraní šachu, jízda auta mezi dvěma křižovatkami)
- predikce – určení kategorie nebo hodnoty nějakého atributu určitého vzorku (detekce spamu, rozpoznání rostliny na fotce, odhad zítřejších srážek)
- generování – vytvoření textu nebo obrázku na základě jiného textu nebo obrázku (odpovídání na otázky, strojový překlad, vygenerování popsaného obrázku)
Mnohé problémy jsou kombinací více typů úloh. Například problém obchodního cestujícího (úloha najít nejkratší cestu, která projde všemi zadanými městy a vrátí se do výchozího bodu) zahrnuje plánování, optimalizaci i splňování podmínek.
Charakteristiky prostředí
Úlohy můžeme dále rozlišovat podle vlastností prostředí, se kterým program interaguje:
Příklady prostředí
Prohledávání stavového prostoru
Souhrn tématu
Prohledávání stavového prostoru je základem mnoha technik umělé inteligence, využívá se například pro řešení logických úloh, výběr optimálního tahu, hledání nejkratší cesty nebo plánování akcí robota.
Stavový prostor úlohy se skládá ze stavů (možné konfigurace úlohy) a akcí (přechody mezi stavy). Jeden ze stavů je počáteční a alespoň jeden stav je cílový. Přechody mohou mít přidruženou cenu.
Stavový prostor jako grafStavový prostor lze reprezentovat ohodnoceným orientovaným grafem, jehož vrcholy odpovídají stavům a hrany akcím. Graf stavového prostoru je pro většinu praktických úloh příliš velký na to, abychom ho celý zkonstruovali v paměti, ale některé prohledávací algoritmy si postupně budují část tohoto grafu.
Plán je libovolná posloupnost akcí. Řešení úlohy je takový plán, který nás dostane z počátečního stavu do cílového. Optimální řešení je řešení, které má nejnižší cenu. (Cena plánu je nejčastěji součet cen jednotlivých přechodů.)
Příklad stavového prostoru (skřítek na mřížce)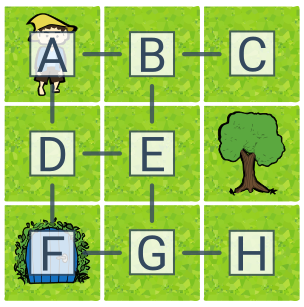
Úlohou je dostat skřítka do domečku. Stavový prostor úlohy má 8 stavů (A–H) a 4 akce (doleva, doprava, dolů, nahoru). Počáteční stav je A, cílový stav F. Optimálním řešením úlohy je např. plán dolů–dolů. Příkladem řešení, které není optimální, je doprava–dolů–dolů–doleva.
Zkoušení všech možností
Kolik je různých plánů? Algoritmus stromového prohledávání
Splňování podmínek v umělé inteligenci
Souhrn tématu
Mnoho úloh umělé inteligence lze formulovat jako splňování podmínek. Úloha splňování podmínek je zadaná sadou proměnných, jejich doménami (možné hodnoty) a sadou podmínek na kombinace hodnot proměnných. Ohodnocení (přiřazení hodnot některým proměnným) je řešením úlohy, pokud je úplné (přiřazuje hodnotu všem proměnným) a konzistentní (neporušuje žádnou podmínku). Někdy je navíc zadána účelová funkce určující hodnotu řešení, kterou chceme optimalizovat.
Oblast informatiky zabývající se touto úlohou se označuje jako programování s omezujícími podmínkami. Splňování podmínek je podstatou mnohých logických úloh (např. problém 8 dam, Einsteinova hádanka, algebrogram). V si můžete vyzkoušet sudoku, ploty a binární křížovku. Praktickou aplikací je třeba sestavování konfigurací produktu splňující zadaná omezení nebo tvorba rozvrhů (školní rozvrhy, jízdní řády, logistika výroby, rozpis zápasů na turnaji).
Problém 8 damÚkol rozestavit na šachovnici 8 dam tak, aby se žádné dvě vzájemně neohrožovaly. (Dáma se může pohybovat o libovolný počet polí vodorovně, svisle i diagonálně.) Úlohu lze zobecnit na „problém N dam“, které máme umístit na šachovnici velikosti N×N.
Einsteinova hádankaÚkol odvodit vlastnosti několika objektů na základě omezených informací. Nejznámější zadání popisuje pět domů, které stojí vedle sebe, liší se barvou, národností majitelů, jejich oblíbeným nápojem, značkou cigaret a domácím mazlíčkem. K dispozici máme 15 informací typu „Angličan žije v červeném domě.“
AlgebrogramÚkol nahradit písmena za různé číslice tak, aby byl splněný zadaný vzorec. Příklad: SEND + MORE = MONEY.
Řešení úloh splňování podmínek
Jakmile nějaký problém namodelujeme jako úlohu splňování podmínek, lze využít obecné postupy pro jejich řešení. Naivní zkoušení všech možných ohodnocení (generuj a testuj) většinou bude příliš pomalé, protože počet možných ohodnocení roste exponenciálně k počtu proměnných. K řešení se proto typicky používá postupné budování řešení s propagací omezení, nebo postupné zlepšování úplného ohodnocení.
Které problémy jsou těžké? Splňování podmínek vs. plánování
Optimalizace
Souhrn tématu
Optimalizace znamená hledání nejlepšího řešení. Hledáme hodnoty optimalizovaných proměnných, při kterých je zadaná účelová funkce nejvyšší (maximum), nebo nejnižší (minimum). Optimalizace se využívá například při plánování výroby, rozvrhování dopravy, návrhu telekomunikačních sítí a trénování modelů ve strojovém učení.
Optimalizační úlohy
Maximalizační a minimalizační úlohy lze řešit stejnými technikami, každý maximalizační problém lze totiž převést na minimalizační úlohu (a naopak) převrácením účelové funkce. Různé techniky se však liší v tom, zda je lze použít v diskrétním či spojitém prostoru (ve spojitém prostoru mohou proměnné nabývat libovolných reálných čísel) a zda může problém obsahovat omezující podmínky.
Příklady optimalizačních úlohProblem batohu. Vybrat kombinaci předmětů, která se vejde do batohu omezené kapacity, aby celková hodnota byla co nejvyšší.
Problém obchodního cestujícího. Najít nejkratší cestu, která projde všemi zadanými městy a vrátí se do výchozího bodu.
Rozvrhování. Najít optimální (nejkratší, nejlevnější) rozvržení aktivit v čase s ohledem na dané zdroje a omezení.
Strojové učení. Zvolit parametry modelu (např. váhy neuronové sítě) minimalizující chybu predikcí na trénovacích datech.
Problém čokoládových sušenek. Najít recept na co nejlepší čokoládové sušenky.
Systematické prohledávání
Nejjednodušším přístupem je zkoušení všech možností (hrubá síla). Ve spojitém prostoru je možností nekonečně mnoho, lze však systematicky vyzkoušet všechny kombinace hodnot s určitým rozlišením (mřížkové prohledávání). Tento přístup je použitelný jen pro velmi malé problémy, protože počet možností roste exponenciálně s počtem proměnných. Při řešení problému batohu můžeme každý předmět buď vzít, nebo nevzít, existuje tedy 2^n možných kombinací předmětů.
Efektivnější je přiřazovat hodnoty proměnným postupně a průběžně odhadovat nejlepší možnou hodnotu řešení s daným částečným přiřazením. Když je tato mez horší než zatím nejlepší nalezené řešení, můžeme celou větev přeskočit a být si jistí, že jsme přitom nepřeskočili optimální řešení. Tato varianta stromového prohledávání se nazývá metoda větví a mezí (angl. branch and bound). Pro výběr dalšího stavu k průzkumu lze využít hladové kritérium – stav s nejlepší hodnotou meze (nebo jinou strategii stromového prohledávání stavového prostoru).
Úlohy a metody umělé inteligence
Doplňování textu • střední

Úlohy a metody umělé inteligence (střední) • NKD
Typicky zabere: 5 min
Prohledávání stavového prostoru
Doplňování textu • střední
Prohledávání stavového prostoru (střední) • NKE
Typicky zabere: 4 min
Prohledávání stavového prostoru
Rozhodovačka • lehké
Prohledávání stavového prostoru (lehké) • NFP
Typicky zabere: 9 min
Splňování podmínek v umělé inteligenci
Doplňování textu • střední

Splňování podmínek v umělé inteligenci (střední) • NKF
Typicky zabere: 4 min
Splňování podmínek v umělé inteligenci
Rozhodovačka • lehké

Splňování podmínek v umělé inteligenci (lehké) • NGB
Typicky zabere: 8 min
Optimalizace
Rozhodovačka • lehké

Optimalizace (lehké) • NGH
Typicky zabere: 6 min
Optimalizace
Doplňování textu • střední

Optimalizace (střední) • NKG
Typicky zabere: 3 min
Princip strojového učení
Souhrn tématu
Umělá inteligence často využívá učení z dat, tzv. strojové učení. Vstupem strojového učení je velké množství dat (dataset), výstupem je naučený model pro řešení požadovaného úkolu. Máme-li dostatek dat popisujících vzhled a chování příšerek, můžeme naučit model, který bude pro nové příšerky odhadovat, zda jsou hodné, na základě jejich vzhledu.
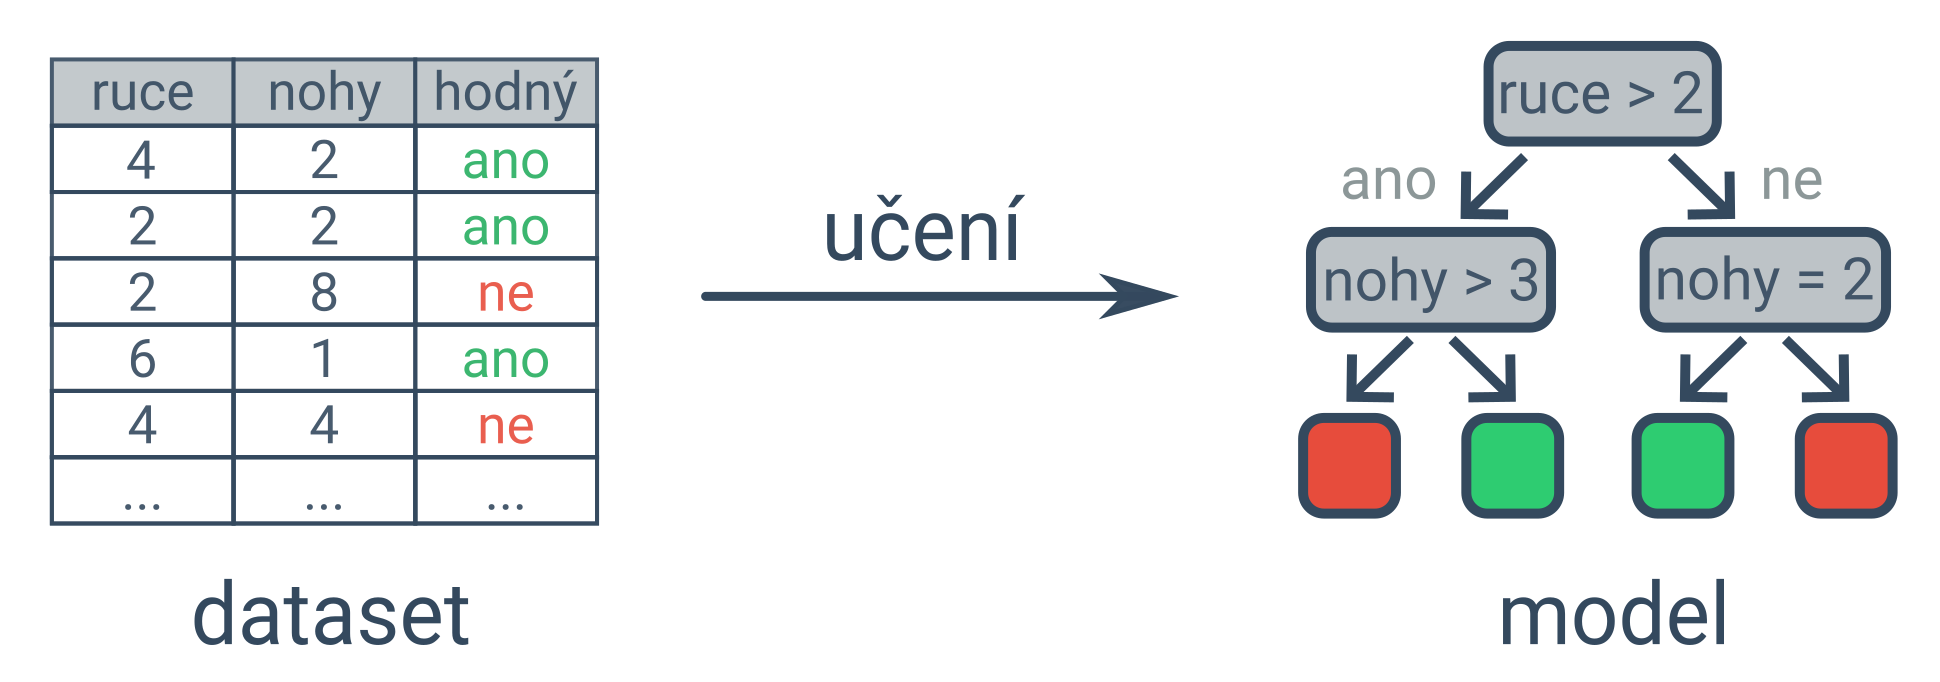
Klíčovou ingrediencí pro strojové učení je velké množství dat. Jednotlivé příklady jsou typicky poměrně jednoduché (např. jedna fotka), ale je jich hodně (někdy i miliony). Aby byl model užitečný, nestačí, aby si zapamatoval trénovací data (memorizace), musí být schopen určovat správný výstup i pro příklady nové (zobecňování, generalizace).
Příkladem modelu je rozhodovací strom (na obrázku výše) nebo neuronová síť (model volně inspirovaný sítí neuronů v mozku). Strojové učení může v závislosti na množství dat trvat vteřiny i celé dny, pro urychlení se proto někdy využívají grafické procesory (GPU, graphics processing unit) a tenzorové procesory (TPU, tensor processing unit).
Strojové učení lze vnímat jako alternativu ke klasickému programování, při kterém programátor zapisuje posloupnost přesných instrukcí (např. if-then pravidla nebo heuristika na základě zkušenosti). Strojové učení bude vhodným přístupem zejména tehdy, když není jasné, jak by takový klasický program měl vypadat a přitom lze sehnat rozsáhlé množství příkladů (např. detekce spamu). Strojové učení spíše nebude vhodným přístupem pro kritická rozhodnutí, kde není tolerovatelná žádná chyba a potřebujeme vysokou předvídatelnost a transparentnost chování (např. bankovní převod).
Aplikace strojového učení (příklady)- detekce spamu
- diagnóza nemoci
- rozpoznání hlasu
- překlad textů
- doporučování filmů
- řízení auta
- generování obrázků podle popisu
Úlohy strojového učení
Souhrn tématu
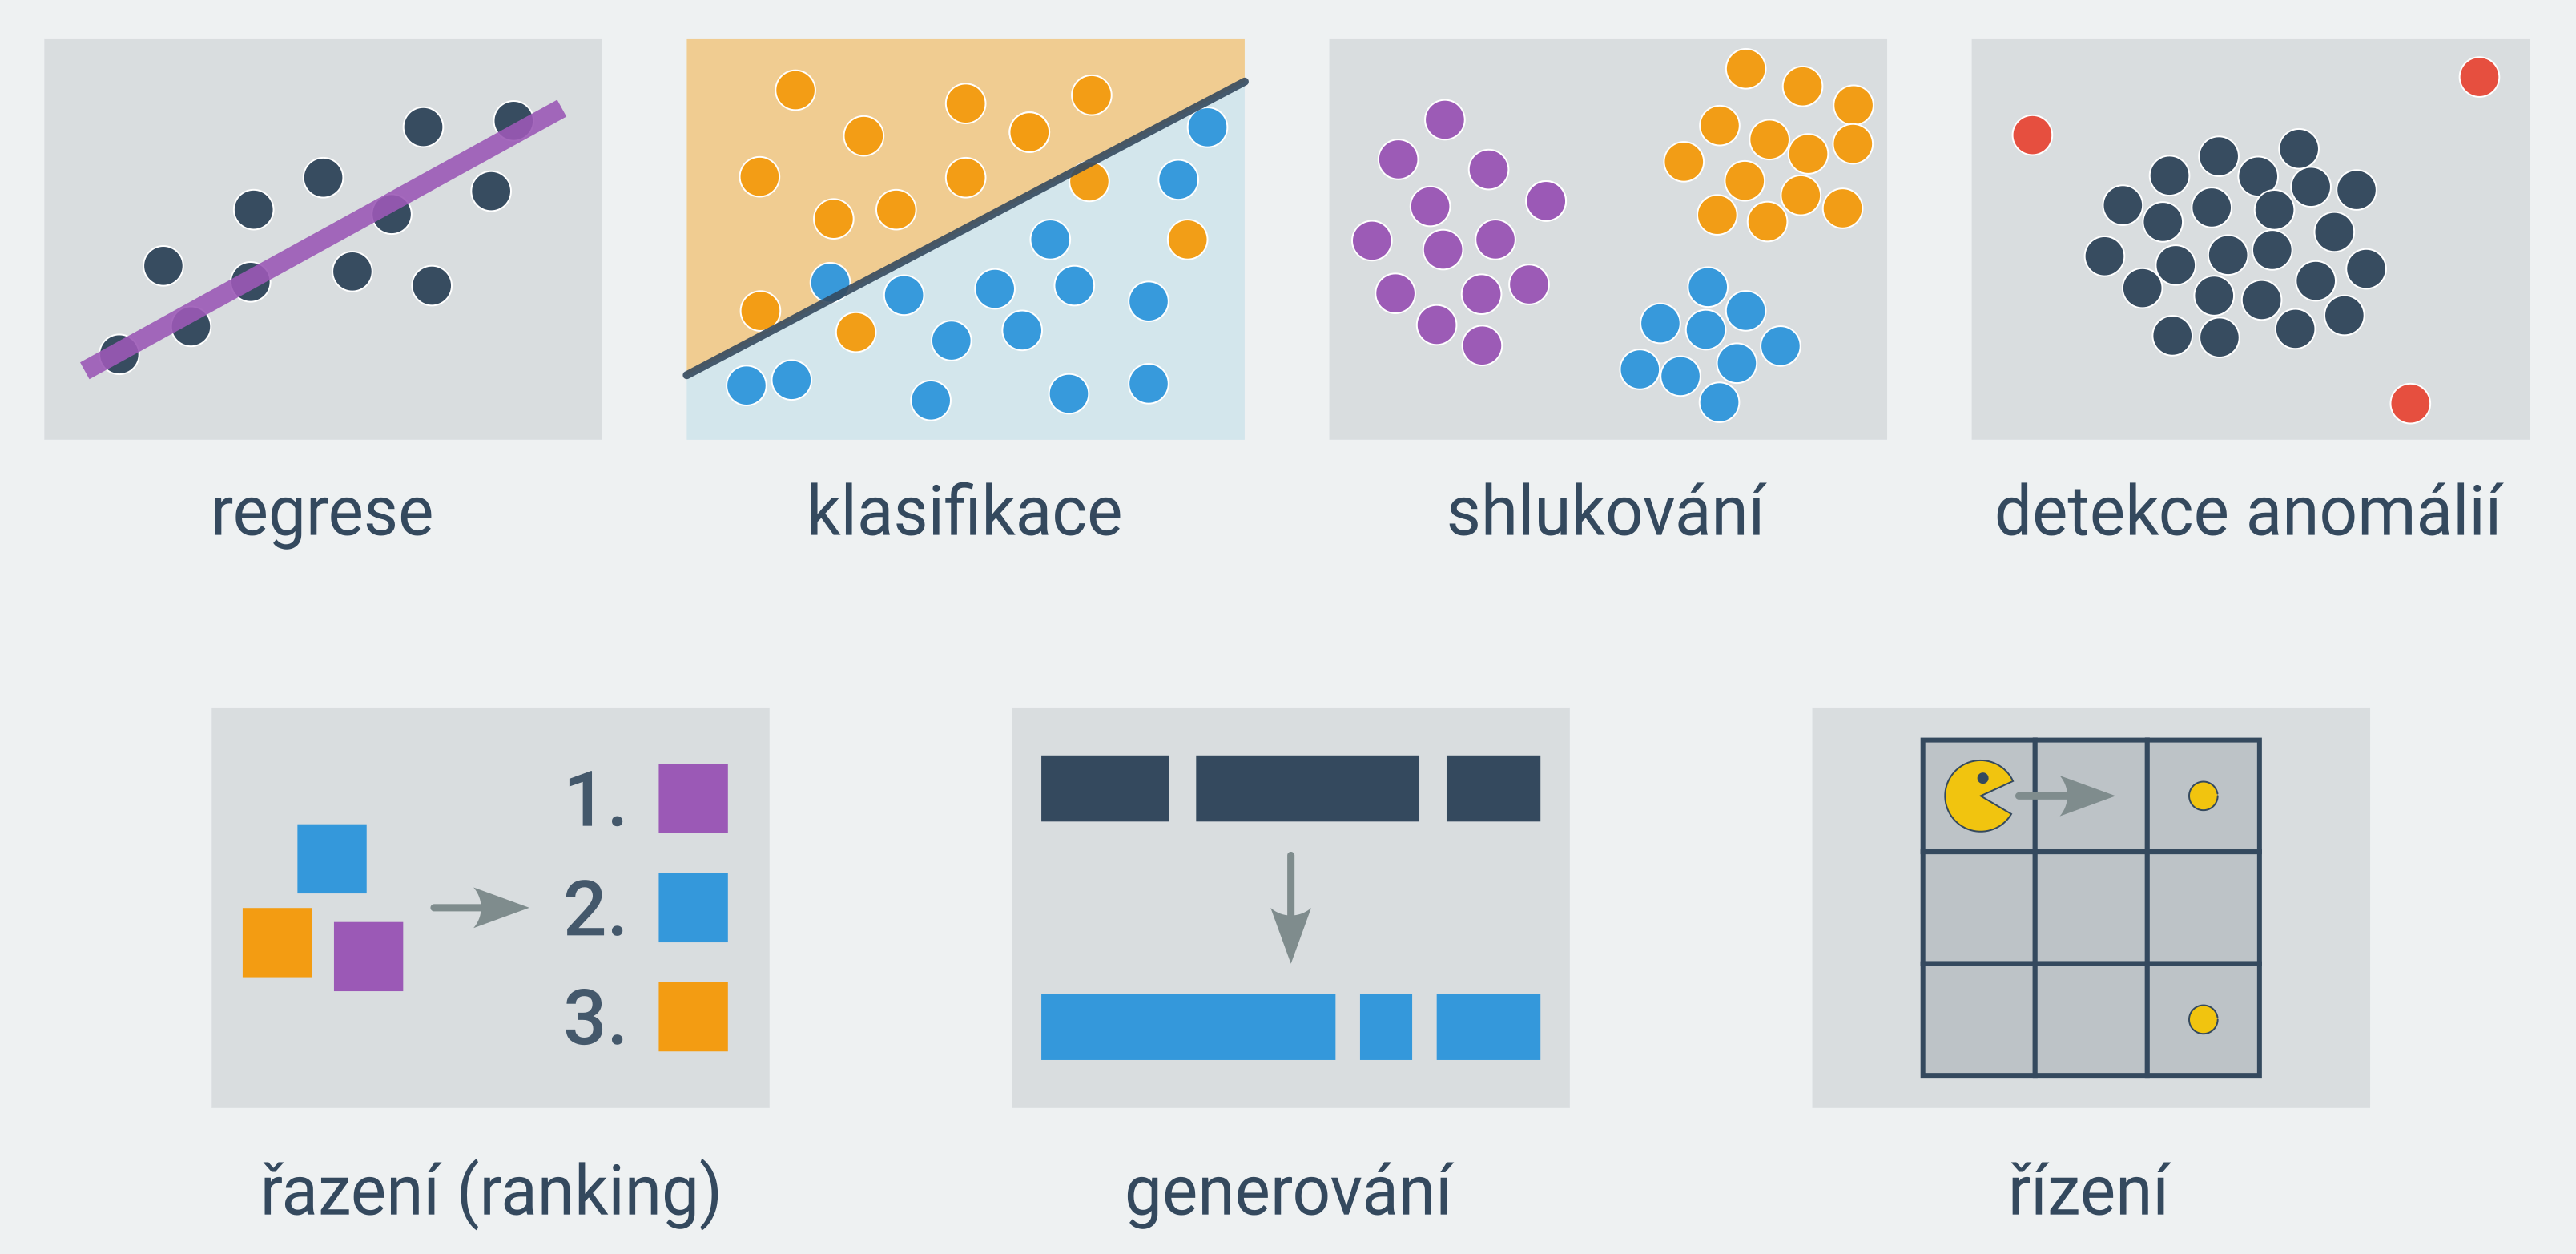
Pomocí strojového učení lze řešit rozličné typy úloh, mezi ty nejčastější patří:
regrese = odhad číselné hodnoty (Jak bude daný uživatel hodnotit daný film? Jaká bude teplota zítra odpoledne?)
klasifikace = určování příslušnosti k jedné z několika předem daných kategorií (Je daný e-mail spam? Která kytka je na fotce?)
shlukování = rozdělení příkladů do skupin s podobnými vlastnostmi (Které zprávy řeší podobné téma? Které chemické látky se chovají podobně?)
hledání anomálií = upozornění na podezřelé příklady, které se výrazně liší od zbytku dat (detekce případů, kdy bankovní účet nevyužívá jeho skutečný majitel)
řazení (ranking) = uspořádání příkladů (seřazení výsledků vyhledávání, seřazení doporučených videí)
generování = vytvoření textu nebo obrázku na základě jiného textu nebo obrázku (odpovídání na otázky, strojový překlad, vygenerování popsaného obrázku)
řízení = hledání strategie pro optimální rozhodování (hraní šachů a podobných her, řízení autonomního auta)
Postup strojového učení
Souhrn tématu
Využití strojového učení zahrnuje následující fáze:
příprava datasetu – může zahrnovat sběr a anotování dat (doplnění požadovaného výstupu)
trénování modelu – určení vhodných hodnot parametrů modelu
testování modelu – na nových datech, která model neviděl během trénování
nasazení modelu – tedy jeho použití pro zadaný úkol
Typy přístupů
Přístupy ke strojovému učení lze rozlišit podle povahy signálu o požadovaném výstupu modelu:
učení s učitelem (angl. supervised learning) – požadovaný výstup je součástí trénovacích dat (např. zda je příšerka hodná, zda je e-mail spam). Doplňování požadovaných výstupů se říká anotování dat. Datům s požadovaným výstupem se pak někdy říká označkovaná data.
učení bez učitele (angl. unsupervised learning) – trénovací data neobsahují požadovaný výstup, úkolem je najít vzory v datech (např. podobné příšerky, podobné zprávy)
posilované učení (někdy též zpětnovazební učení, angl. reinforcement learning) = učení skrze interakci s prostředím zahrnující zpětnou vazbu na provedené akce (např. výhra v šachu, řízení auta bez nehod)
Různé přístupy jsou vhodné na různé typy úloh. Učením s učitelem se typicky řeší regrese, klasifikace, řazení a generování, učením bez učitele shlukování a hledání anomálií, posilovaným učením řízení. Často se však přístupy kombinují.
Modely
Příklad učení lineárního klasifikátoru příšerek
Princip strojového učení
Doplňování textu • střední

Princip strojového učení (střední) • NKH
Typicky zabere: 4 min
Princip strojového učení
Rozhodovačka • střední

Princip strojového učení (střední) • NC2
Typicky zabere: 6 min
Princip strojového učení
Porozumění

Princip strojového učení • NEG
Úlohy strojového učení
Rozhodovačka • střední

Úlohy strojového učení (střední) • NDH
Typicky zabere: 3 min
Postup strojového učení
Rozhodovačka • střední

Postup strojového učení (střední) • NDJ
Typicky zabere: 6 min
Postup strojového učení
Krok po kroku • střední

Postup strojového učení (střední) • NDX
Typicky zabere: 9 min
Postup strojového učení
Porozumění

Postup strojového učení • NEH

Předpojatost v umělé inteligenci
Označování • střední

Předpojatost v umělé inteligenci (střední) • N2V
Typicky zabere: 9 min
Vyhodnocení strojového učení
Krok po kroku • střední
Vyhodnocení strojového učení (střední) • NDZ
Typicky zabere: 5 min
Vyhodnocení strojového učení
Porozumění
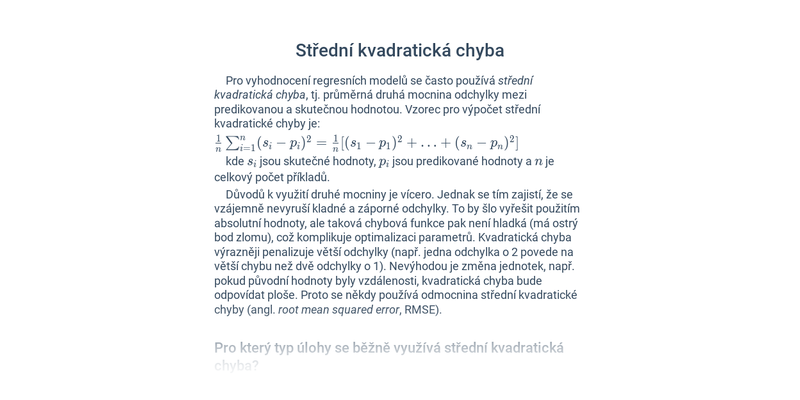
Vyhodnocení strojového učení • NEK
Vyhodnocení strojového učení
Rozhodovačka • střední
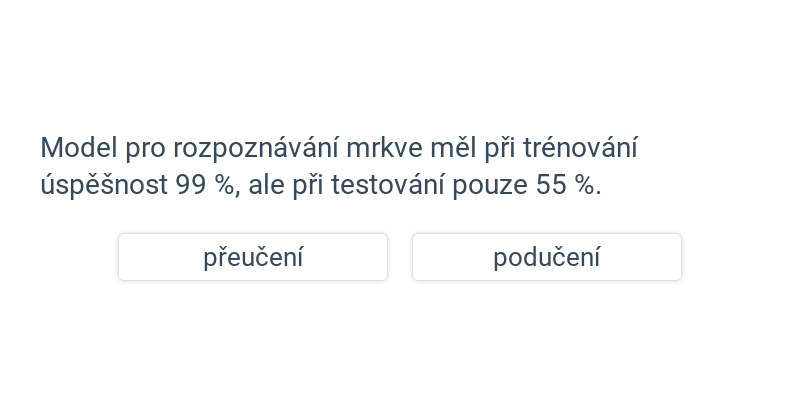
Vyhodnocení strojového učení (střední) • NDK
Typicky zabere: 7 min
Zkreslení strojového učení
Porozumění

Zkreslení strojového učení • NEL
Zkreslení strojového učení
Krok po kroku • střední

Zkreslení strojového učení (střední) • ND1
Typicky zabere: 4 min
Zkreslení strojového učení
Rozhodovačka • střední

Zkreslení strojového učení (střední) • NDL
Typicky zabere: 7 min
Základy umělé inteligence: mix
Rozhodovačka • střední

Základy umělé inteligence: mix (střední) • NF4
Typicky zabere: 6 min
Metody umělé inteligence: mix
Rozhodovačka • lehké

Metody umělé inteligence: mix (lehké) • NGS
Typicky zabere: 6 min
Základy strojového učení: mix
Rozhodovačka • střední

Základy strojového učení: mix (střední) • NF6
Typicky zabere: 6 min
Strojové učení: pojmy
Rozhodovačka • střední